两台 DGX Spark 128G 跑 Qwen3.8-27B:一次完整深度优化
客户问我们最多的两个问题,一个是「数据能不能不出公司」,一个是「本地部署的话,AI 硬件预算我们扛不扛得住」。
前一个好回答。后一个以前不好回答——在很多人的印象里,把大模型搬回自己公司,等于一屋子 GPU 服务器、专线供电和机房空调,还没开始就是一笔很难批下来的预算。
我们想给的答案是另一个:不用机房,两台桌面 AI 设备就够。
这不是拿现成方案跑个分——这套双机部署是我们自己一版一版调出来的:从跑不起来,到跑得起来但慢,到今天能接住真实业务。下面这些数字是这套方案的验收结果,9 月 8 日实测,覆盖质量、速度、稳定性、容量四个维度,不是估算。
这套方案长什么样
配置先摆出来,免得数字没有参照:
- 硬件:两台 NVIDIA DGX Spark(GB10),每台 128 GB 统一内存,两台合计 256 GB,200G 铜缆直连,放在办公室里,普通电源
- 并行:张量并行 TP=2,模型权重两台各放一半(每台约 10.5 GB)
- 模型:
Qwen3.8-27B-NVFP4——通义千问 270 亿参数模型的混合 NVFP4 量化版本,权重 21 GB - 上下文:原生 262144 token(约 20 万汉字)
- 负载:不是跑分专用机,评测期间集群同时在服务易客 Claw、会议 Agent 和 DSH Desktop 编码的真实流量
一、质量:本地部署没有精度损失
最该担心的是这个:模型量化过、又跑在自己的小机器上,会不会变笨。
我们用 GSM8K 数学推理测试,从官方 test split 里按固定种子抽 300 题,全部程序判定,不做人工打分。
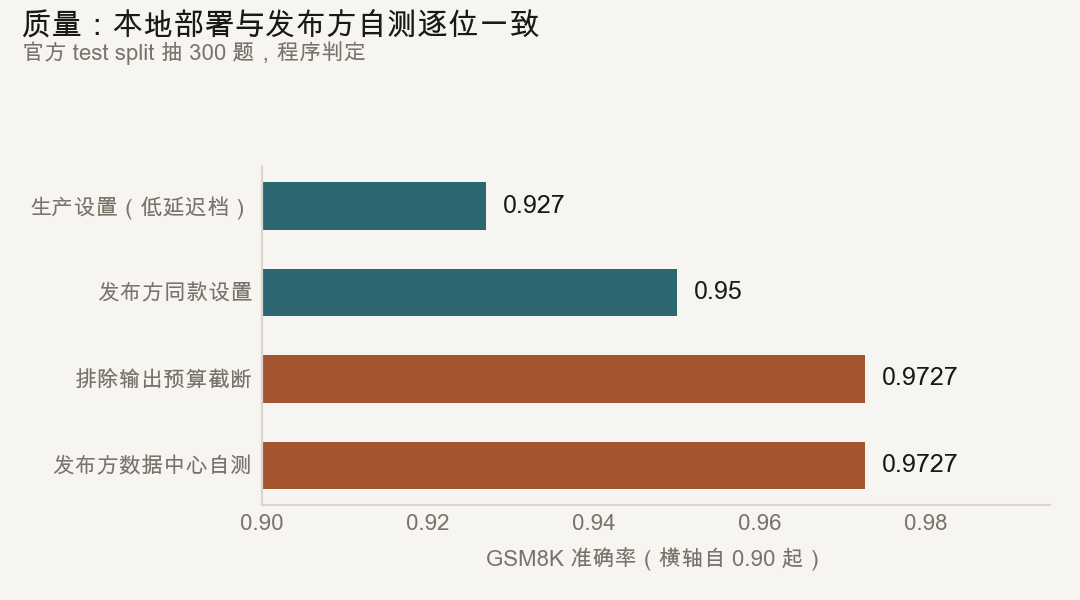
按模型发布方的同款采样设置跑,我们打到 0.950;把其中 7 例「推理写得太长、撞上输出预算被截断」的排除后是 0.9727——与发布方在四卡旗舰 GPU 数据中心里自测的 0.9727 逐位一致。
也就是说,量化 + 双机部署这一整套,没有引入可测量的精度损失。
另外 51 项能力测试通过 50 项,覆盖指令遵循、工具调用、多轮工具链、会议纪要转任务、长文档检索、事实忠实性。「不知道就说不知道」那一组全过——问未来的事、问材料里没有的内容、问不存在的函数,模型都明确说不知道,没有编造。
二、单流速度:快慢由内容决定
一个反直觉的发现:同一个模型、同一套设置,只换生成的内容,速度能差 1.7 倍。
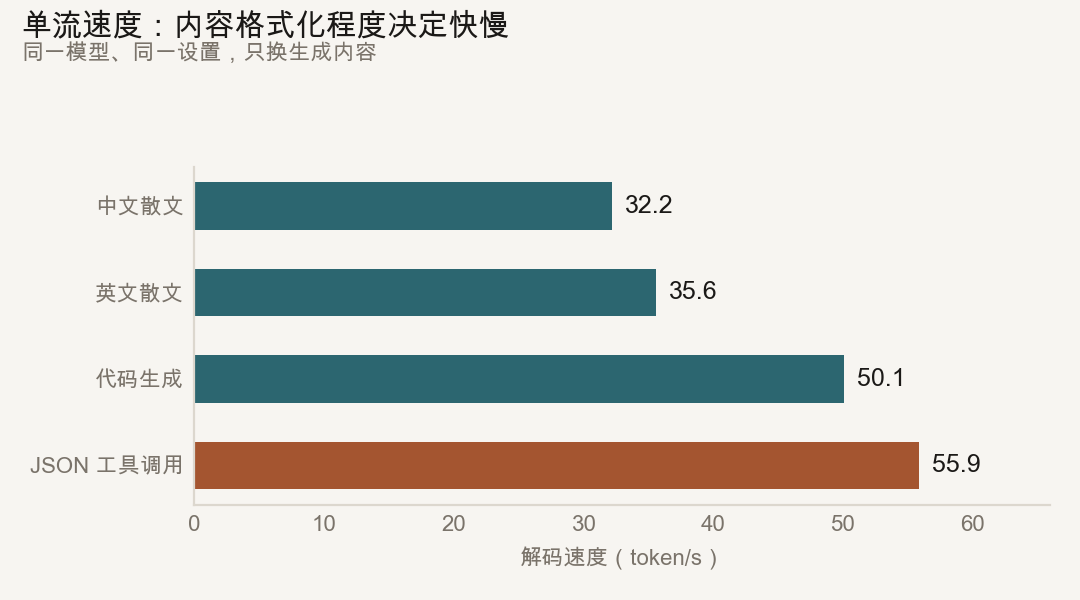
中文散文 32.2 token/s,而 JSON 工具调用能到 55.9。原因在于每一步的墙钟时间基本恒定,格式化程度越高的内容,每一步能确定下来的 token 越多。
这对 agent 场景是好消息:agent 干活时输出的大量是结构化的工具调用,正好落在最快的那一档。
三、并发:16 路仍未见拐点
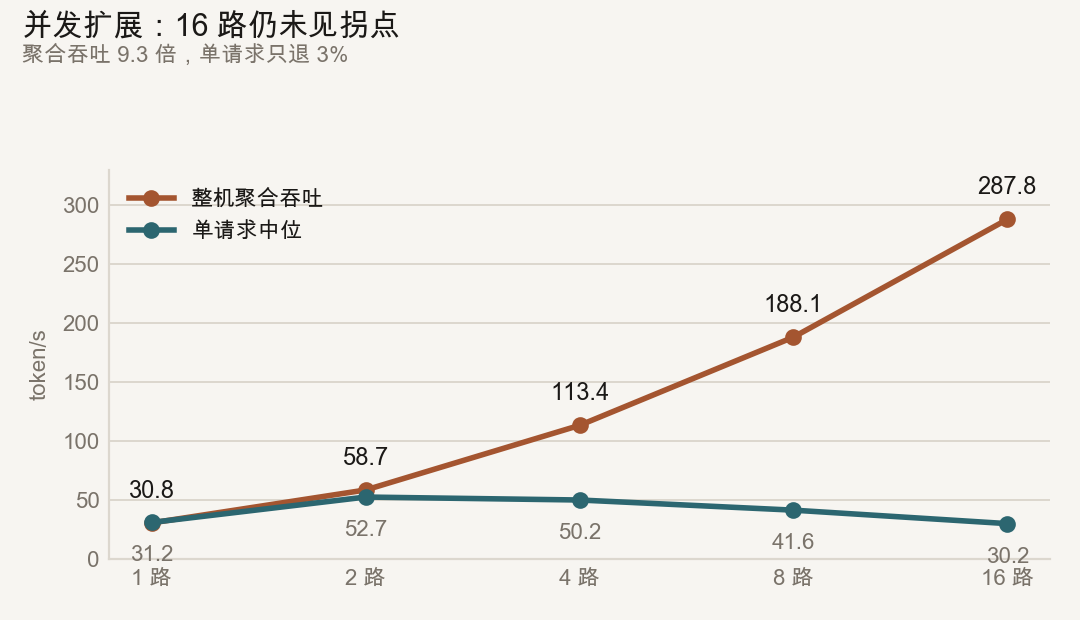
16 路并发时整机聚合吞吐 287.8 token/s,是单流的 9.3 倍,而单个用户的体感只退了 3%。
原因是这套硬件的瓶颈在权重带宽而不是算力,批量把读权重的代价摊薄了,所以并发很划算——多个人同时用,整体产出接近线性增长,而不是互相抢资源。
四、长上下文:26 万 token,中间的内容也找得到
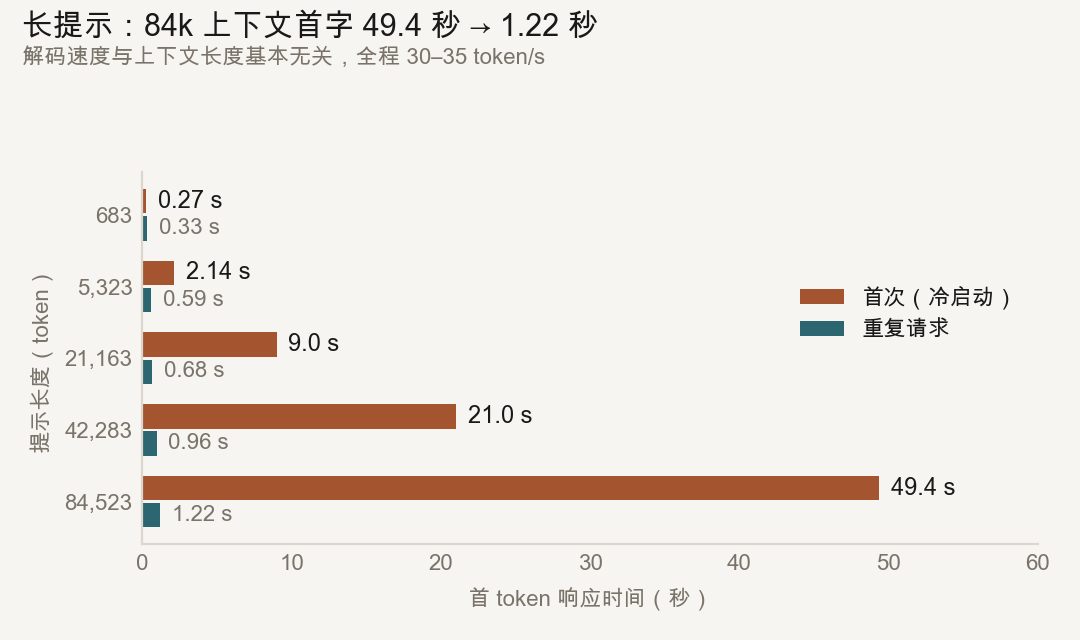
三个结论:
- 预填是线性成本:提示越长,第一次的等待越久,84k token 的提示冷启动要 49.4 秒
- 重复请求几乎不用等:同样 84k 的提示,重复请求首字只要 1.22 秒,压掉 97%
- 解码速度与上下文长度基本无关:从 683 token 到 84k,全程稳定在 30–35 token/s
召回也验过:在一份 6.9 万 token 的长文档正中间埋入关键信息,代号和金额全部准确召回——不是只会看开头结尾。
五、连续多轮:上下文增长不拖慢每一步
单项指标之外,还要看连续多轮任务里上下文不断变长会不会越跑越慢。我们按 CRM agent 的模式测了 8 轮(固定长系统提示 + 每轮带上全部历史重发):
- 前两轮在付第一次的预填成本
- 从第 3 轮起进入稳态,每步耗时不再随轮次上升——之后每一步只需处理新增的几十个 token
一步实际要多久,取决于这一步输出多少内容、要不要走工具调用。
六、稳定性:7 小时零故障
- 同一个容器连续运行 7 小时、处理 887 个真实业务请求 / 3860 万 prompt token:零抢占、零中断、零失败
- 混合负载压测 20 分钟 262 个请求,零失败零超时,前后半段没有性能漂移
- 本次评测额外打进去的 600 多次请求,同样零错误
七、这套方案比标准装法快了多少
这张图是我们自己最在意的一张——它衡量的不是硬件,是方案本身:
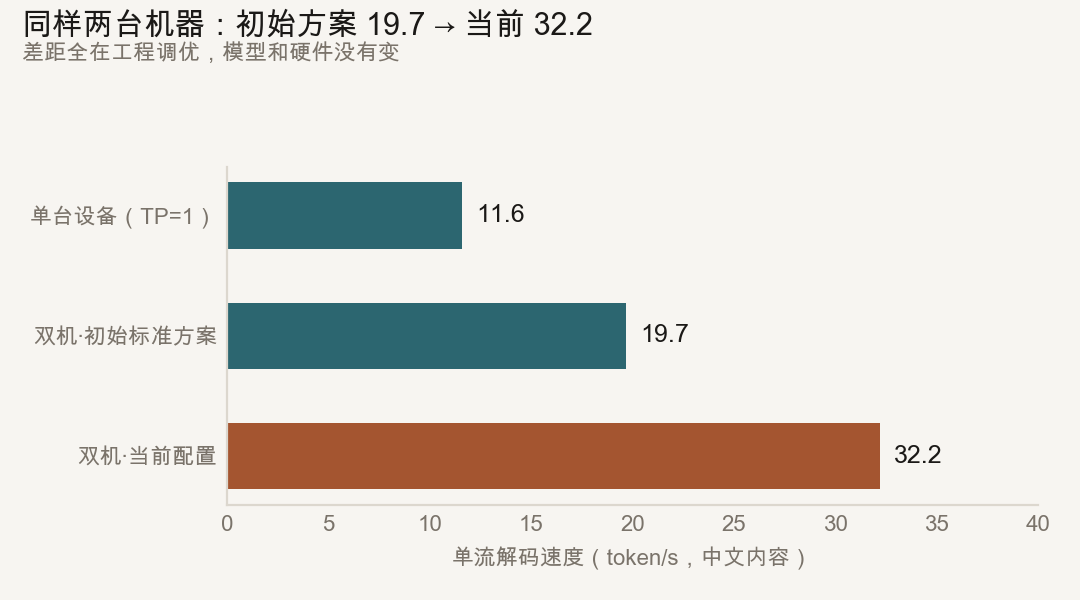
同样两台设备、同样的 Qwen3.8-27B-NVFP4,按标准方式装出来是 19.7 token/s,我们这套方案是 32.2——单流快 63%,多路聚合快 84%。硬件没换,模型没换,差在方案。
换句话说:把设备买回来、把模型装上,只能拿到其中一半多一点的性能。
顺带一个对照:这套双机比单台设备快 1.8 倍(单台 11.6 token/s,且预填慢 57%)。
八、顺带一个例子:让它写一个「网页版 macOS」
指标之外,再看一个直观的:我们用这套本地模型接上 DSH Desktop 编码,让它从零写一个跑在浏览器里的 macOS 桌面。
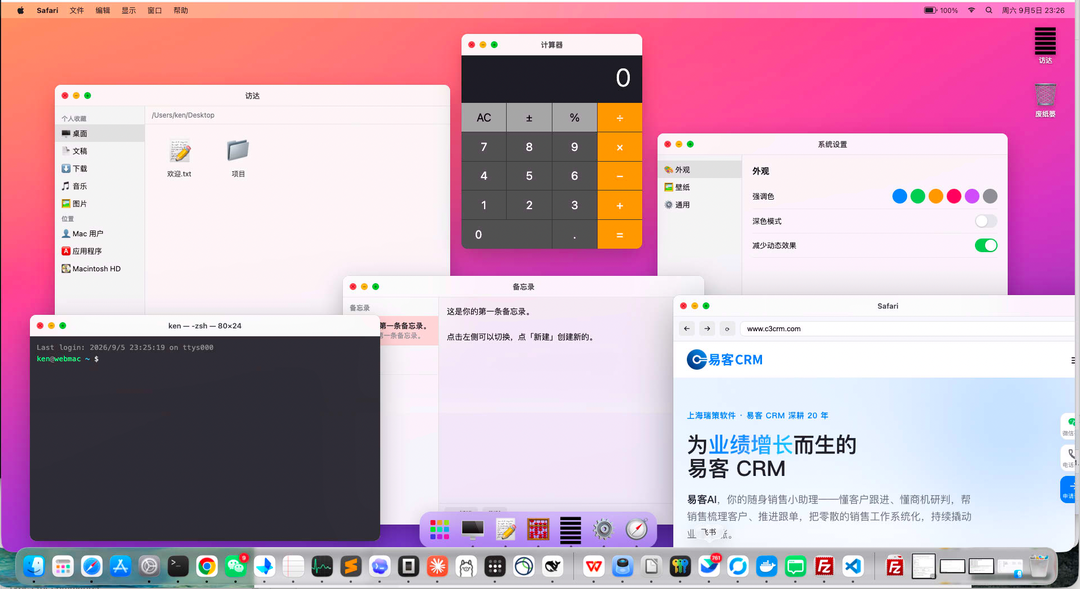
访达能浏览目录、计算器能按、备忘录能编辑、系统设置里强调色和深色模式能切、终端有提示符、内置浏览器能打开网页;窗口可拖动、可层叠、可最小化,Dock 和顶部菜单栏都在。
这类活最能看出模型的成色——不是答一道题,而是要在一堆文件里把状态、交互和样式都保持一致,还得自己收尾。本地跑的 27B 能做到这个程度,日常的业务开发和 agent 任务就不用担心它不够聪明。
小结
两台 DGX Spark、200G 铜缆直连、TP=2,跑 Qwen3.8-27B-NVFP4:
- 质量:与发布方在数据中心的自测成绩一致,量化加双机部署没有带来精度损失
- 速度:单流 32–56 token/s,取决于生成内容的格式化程度;16 路并发聚合 287.8 token/s,单请求只退 3%
- 长上下文:26 万 token 可用,6.9 万 token 文档中部埋点全部召回,重复请求首字 1.22 秒
- 稳定性:连续 7 小时真实业务零故障
- 方案本身:同样的设备、同样的模型,按标准方式装出来是 19.7 token/s,深度优化之后是 32.2
数据全部在自己的机器上处理,不经过第三方 API,也不需要机房。